AIの利活用による並列秘密計算コード自動生成
詳細はプロジェクトHPをご覧ください.高性能計算機システムにおける電力管理方式
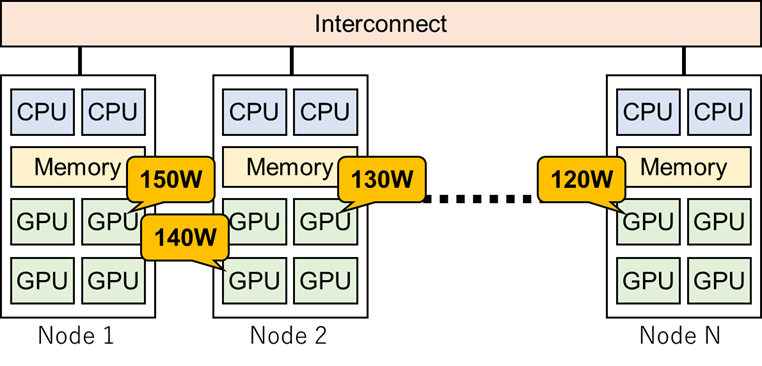
将来のスーパーコンピュータは30MW程度の電力制約のもとでエクサフロップス(浮動小数点演算を1秒間に1,000,000,000,000,000,000回)を超える演算性能を実現することが求められています.このような高い電力効率を実現するためには,CPU,GPUなどのアクセラレータ,メモリ,ネットワークなどのさまざまなデバイスの電力効率を高める必要があります.特に,CPUやGPUなどの半導体チップには製造ばらつきに起因する消費電力のばらつき(電力ばらつき)が存在することが知られており,この電力ばらつきを上手く利用することでシステムは同じ仕事をより少ない消費電力で行うことができるようになります.当研究室では,実運用中のスパコンにおける電力ばらつきの評価と省エネルギー化のための資源割り当てアルゴリズムの開発を行っています.本研究は,理化学研究所計算科学研究センターと共同で行っています.
代表的な研究成果
- K. Yoshida, H. Yamaki, H. Honda, K. Sato, and S. Miwa, Combining System- and User-Level Approaches to Improving Energy Efficiency in GPU-Based Supercomputers, The International Conference on High Performance Computing in Asia-Pacific Region (HPCASIA'26) Workshops, pp. 22-30 (2026)
- K. Yoshida, R. Sakamoto, K. Sato, A. Bhatele, H. Yamaki, H. Honda, and S. Miwa, VAHRM: Variation-Aware Resource Management in Heterogeneous Supercomputing Systems, IEEE Transactions on Parallel and Distributed Systems, Vol. 36, Issue 8, pp.1713-1727 (2025).
- K. Yoshida, S. Miwa, H. Yamaki, and H. Honda, Analyzing the Impact of CUDA Versions on GPU Applications, Parallel Computing, Vol.120, No.103081, 10 pages, Elsevier (2024).
- T. Kusaba, Y. Awaki, K. Yoshida, S. Miwa, H. Yamaki, T. Hanawa, and H. Honda, Power-Efficiency Variation on A64FX Supercomputers and its Application to System Operation, 2024 IEEE International Conference on Cluster Computing Workshops (CLUSTER Workshops), pp. 55-65 (Sep 2024).
- K. Yoshida, R. Sageyama, S. Miwa, H. Yamaki, and H. Honda, Analyzing Performance and Power-Efficiency Variations among NVIDIA GPUs, The 51st International Conference on Parallel Processing (ICPP), No. 65, pp.1-12 (acceptance rate: 84/311=27%).
次世代半導体デバイスを利用したプロセッサアーキテクチャ
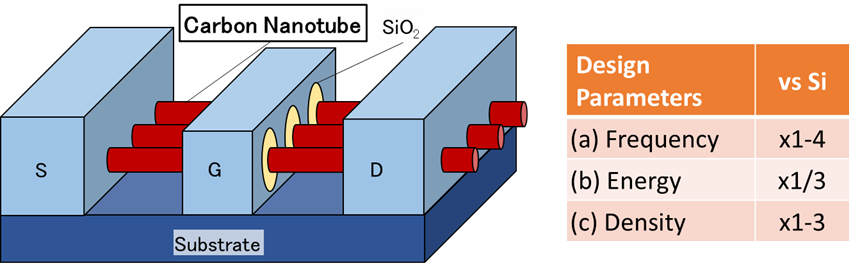
現在のプロセッサの多くはシリコントランジスタによって製造されており,シリコントランジスタの微細化とともにその性能を向上させてきました.しかし,長年の微細化によってトランジスタの各部の大きさはナノメートル規模にまで縮小し,その結果として更なる微細化が困難となりつつあります.シリコントランジスタの微細化に依存しないプロセッサの性能向上手段としてカーボンナノチューブトランジスタと呼ばれる次世代半導体デバイスが注目を集めており,当研究室ではカーボンナノチューブトランジスタを用いたプロセッサの設計技術とアーキテクチャの開発を行っています.東京大学,名古屋大学,九州大学と共同で研究を行っています.
代表的な研究成果
- S. Miwa, E. Sekikawa, T. Yang, R. Shioya, H. Yamaki, and H. Honda, CACTI-CNFET: an Analytical Tool for Timing, Power, and Area of SRAMs with Carbon Nanotube Field Effect Transistors, The 30th Asia and South Pacific Design Automation Conference (ASP-DAC), pp. 1350-1356 (2025) (acceptance rate: 168/587=29%)
- C. Shi, T. Koizumi, R. Shioya, H. Yamaki, H. Honda, and S. Miwa, MOOPSE: Leveraging High-Radix Booth Encoders for Area-Efficient Matrix Multiply Operations, 2025 62nd ACM/EDAC/IEEE Design Automation Conference (DAC), Work-in-Progress Session (poster presentation) (2025)
- C. Shi, S. Miwa, T. Yang, R. Shioya, H. Yamaki, and H. Honda, CNFET-OCL: Open-source Cell Libraries for Advanced CNFET Technologies, IEEE Access, Vol.12, pp. 165335-165347 (2024).
- C. Shi, S. Miwa, T. Yang, R. Shioya, H. Yamaki, and H. Honda, Analysis of 64-bit Parallel Prefix Adders and 32-bit Matrix Multiply Units Designed with 7-nm CNFET, 2024 61st ACM/EDAC/IEEE Design Automation Conference (DAC), Work-in-Progress Session (poster presentation) (Jun 2024).
- C. Shi, S. Miwa, T. Yang, R. Shioya, H. Yamaki, and H. Honda, CNFET7: An Open Source Cell Library for 7-nm CNFET Technology, The 28th Asia and South Pacific Design Automation Conference (ASP-DAC), pp.763-768 (acceptance rate: 102/328=31%).
複数TEEを用いた並列計算のためのシステムソフトウェア開発
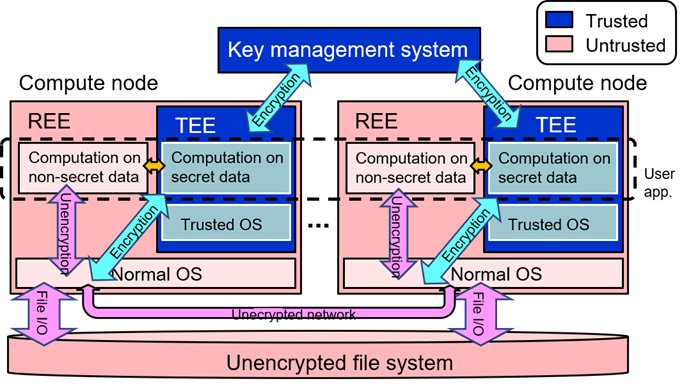
Society5.0を支えるICT基盤として,これまでにない安全性と高い性能を兼ね備えた計算機システムが必要とされています.このような観点から,私たちの研究室ではTEE(Trusted Execution Environment)を用いた並列計算環境に関する研究を行っています.具体的には,TEE間で高速かつ安全にデータ通信を行うためのMPIライブラリやTEE向けの暗号化ファイルシステムの開発などを行っています.本研究は,理化学研究所計算科学研究センターと共同で行っています.
代表的な研究成果
- K. Shimojima, H. Yamaki, H. Honda, S. Matsuo, A. Takefusa, and S. Miwa, MPI-SGX: Enabling Confidential Computing for MPI Parallel Applications with Intel SGX Technology, The International Conference for High Performance Computing, Networking, Storage and Analysis (SC25, poster presentation) (2025) (Best Poster Candidate)
- K. Shimojima, S. Miwa, H. Yamaki, and H. Honda, Evaluating MPI Performance on SGX and Gramine, 2024 IEEE International Conference on Cluster Computing Workshops (CLUSTER Workshops) (poster presentation), pp. 172-173 (Sep 2024)
- S. Miwa, and S. Matsuo, Analyzing the Performance Impact of HPC Workloads with Gramine+SGX on 3rd Generation Xeon Scalable Processors, The SC'23 Workshops of the International Conference on High Performance Computing, Network, Storage, and Analysis (SC-W'23), pp. 1850-1858 (Nov 2023).